《Go程序设计语言》笔记 第4章 复合类型
在第3章,我们讨论了基本类型,它们是Go宇宙中的“原子”。在本章中,将介绍复合类型(composite type),即由原子组合成的“分子”。我们将讨论四种复合类型——数组、切片、映射和结构体。在本章末尾,将展示如何将使用这些类型的结构化数据编码和解析JSON数据,以及如何从模板生成HTML。
数组和结构体是聚合类型(aggregate type),在内存中它们的值是由其他值拼接而成的。数组是同构的(所有元素都有相同的类型),而结构体是异构的。数组和结构都体是固定大小,而切片和映射是动态大小,随着值的添加而增长。
4.1 数组
数组(array)是特定类型的零个或多个元素构成的固定长度序列。由于数组的长度是固定的,因此很少直接使用。切片的用途更广,但为了理解切片必须先理解数组。
类型[n]T是长度为n的T类型数组。可以使用传统的下标语法访问单个数组元素,其中下标从0到n-1。内置函数len()返回数组的长度。也可以使用range循环遍历数组。
1
2
3
4
5
6
7
8
9
10
11
12
13
var a [3]int             // array of 3 integers
fmt.Println(a[0])        // print the first element
fmt.Println(a[len(a)-1]) // print the last element, a[2]

// Print the indices and elements.
for i, v := range a {
	fmt.Printf("%d %d\n", i, v)
}

// Print the elements only.
for _, v := range a {
	fmt.Printf("%d\n", v)
}
默认情况下,数组的所有元素都初始化为元素类型的零值。也可以使用数组字面值用一个值列表来初始化数组(如果值的个数小于数组长度,则剩余元素初始化为零值):
1
2
3
var q [3]int = [3]int{1, 2, 3}
var r [3]int = [3]int{1, 2}
fmt.Println(r[2]) // "0"
在数组字面值中,如果用省略号...代替长度,则数组长度由初始值的数量决定。q的定义可以简化为
1
2
q := [...]int{1, 2, 3}
fmt.Printf("%T\n", q) // "[3]int"
数组的大小是其类型的一部分,因此[3]int和[4]int是不同的类型。数组大小必须是常量表达式(即可以在编译时求值的)。
1
2
q := [3]int{1, 2, 3}
q = [4]int{1, 2, 3, 4} // compile error: cannot assign [4]int to [3]int
数组字面值也可以指定索引和值的列表,如下所示:
1
2
3
4
5
6
7
8
9
10
11
type Currency int

const (
	USD Currency = iota
	EUR
	GBP
	RMB
)

symbol := [...]string{USD: "$", EUR: "€", GBP: "£", RMB: "¥"}
fmt.Println(RMB, symbol[RMB]) // "3 ¥"
在这种形式中,索引的顺序可以任意,也可以省略,未指定的值是零值。例如,
1
r := [...]int{99: -1}
定义了包含100个元素的数组r,最后一个元素值为-1,其他元素都是0。
如果数组的元素类型是可比较的,那么该数组类型也是可比较的。此时可以使用==运算符直接比较两个数组,如果所有对应元素相等则数组相等。
1
2
3
4
5
6
a := [2]int{1, 2}
b := [...]int{1, 2}
c := [2]int{1, 3}
fmt.Println(a == b, a == c, b == c) // "true false false"
d := [3]int{1, 2}
fmt.Println(a == d) // compile error: cannot compare [2]int == [3]int
注:只有相同类型(元素类型+长度)的数组才可以比较,包括使用!=。
作为一个真实的例子,crypto/sha256包中的函数Sum256()生成存储在字节切片中的任意消息的SHA256加密哈希,或称为摘要(digest)。摘要是256位,因此其类型为[32]byte。如果摘要相同,这两条消息极有可能是相同的(哈希碰撞的概率极低);如果摘要不同,这两条消息必然不同。这个程序打印并比较了 "hello" 和 "Hello" 的SHA256摘要:
程序的输出如下:
1
2
3
4
2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824
185f8db32271fe25f561a6fc938b2e264306ec304eda518007d1764826381969
false
[32]uint8
这两个输入仅相差一个字符,但摘要完全不同。注意Printf动词:%x也可用于字节数组或切片,以十六进制打印所有元素,%t显示布尔值,%T显示值的类型。
在Go中调用函数时,数组参数是按值传递的(与Java等语言不同),因此函数接收的是副本而不是原始数组。以这种方式传递大型数组效率会很低,并且函数对数组元素所做的修改不会影响原始数组。例如,下面这个将数组清零的函数zero()无法达到预期的效果:
1
2
3
4
5
6
7
8
9
arr := [5]int{1, 2, 3, 4, 5}
zero(arr)
fmt.Println(arr) // "[1 2 3 4 5]"

func zero(a [5]int) {
	for i := range a {
		a[i] = 0
	}
}
一种解决方法是传递一个指向数组的指针,这样调用方就可以看到函数对数组元素所做的修改:
1
2
3
4
5
6
7
8
9
arr := [5]int{1, 2, 3, 4, 5}
zero(&arr)
fmt.Println(arr) // "[0 0 0 0 0]"

func zero(ptr *[5]int) {
	for i := range ptr {
		ptr[i] = 0
	}
}
数组字面值[5]int{}会生成5个int的数组,每个元素都是0。可以利用这一点简化zero()函数:
1
2
3
func zero(ptr *[5]int) {
	*ptr = [5]int{}
}
注:另一种方式是使用切片,见4.2节。
虽然使用指针来传递数组是高效的,而且也允许在函数内部修改数组,但数组由于其固定大小仍然是不灵活的。例如,zero()函数不接受指向[4]int的指针,也没有任何添加或删除数组元素的方法。由于这些原因,除了像SHA256的固定大小哈希等特殊情况外,数组很少用作函数参数或结果。相反,通常使用切片。
练习4.1 编写一个函数,统计两个SHA256哈希中不同的比特位数量。(参考2.6.2节的PopCount())
练习4.2 编写一个程序,打印标准输入的SHA256哈希,支持通过命令行参数选择SHA384或SHA512。
4.2 切片
切片(slice)表示所有元素都有相同类型的变长序列。切片类型写为[]T,其中T是元素类型。
数组和切片有紧密的联系。切片是一种轻量级的数据结构,可以访问一个数组(或其子数组)中的元素,这叫做切片的底层数组(underlying array)。切片有三个组成部分:指针、长度和容量。指针指向切片可访问的第一个元素(不一定是数组的第一元素)。长度是切片的元素数量,它不能超过容量(容量通常是切片开始到底层数组末尾之间的元素数量)。内置函数len()和cap()分别返回切片的长度和容量。
注:Go的切片类似于C++的std::span。
多个切片可以共享同一个底层数组,并且引用的部分可能重叠。下图显示包含月份名称的数组及其两个重叠的切片。
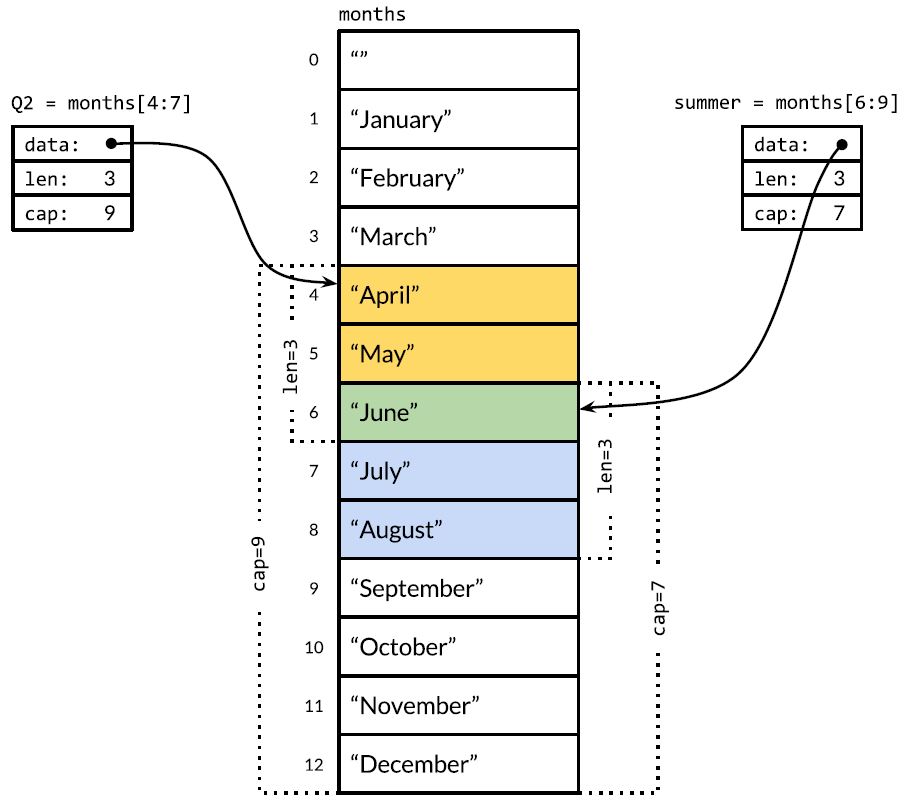
该数组声明为
1
months := [...]string{"", "January", "Fenruary", ..., "December"}
切片运算符 s[i:j](其中0 ≤ i ≤ j ≤ cap(s))创建一个新的切片,引用序列s的元素i到j-1,s可以是数组、数组指针或另一个切片。生成的切片有j-i个元素。如果省略i则为0,如果省略j则为len(s)。因此,切片months[1:13]或months[1:]引用整个有效月份范围,months[:]引用整个数组。下面定义表示第二季度和北方夏季的切片(二者都包含六月):
1
2
3
4
Q2 := months[4:7]
summer := months[6:9]
fmt.Println(Q2)     // ["April" "May" "June"]
fmt.Println(summer) // ["June" "July" "August"]
切片超出cap(s)会导致panic,但是超出len(s)会扩展切片,因此结果可能比原切片更长:
1
2
3
4
fmt.Println(summer[:20]) // panic: out of range

endlessSummer := summer[:5] // extend a slice (within capacity)
fmt.Println(endlessSummer)  // "[June July August September October]"
另外,注意字符串的子串操作(见3.5节)与[]byte的切片运算符之间的相似性:二者都写为x[m:n],都返回原始字节的子序列,都共享底层表示,并且都是常数时间复杂度。
由于切片包含指向数组元素的指针,因此将切片传递给函数允许函数修改底层数组元素。换句话说,复制切片会创建底层数组的一个别名(见2.3.2节)。函数reverse()原地反转[]int切片的元素,可用于任意长度的切片。
像这样反转整个数组:
1
2
3
a := [...]int{0, 1, 2, 3, 4, 5}
reverse(a[:])
fmt.Println(a) // "[5 4 3 2 1 0]"
将切片向左旋转n个元素的一种方法是调用reverse()函数三次:首先反转前n个元素,然后是剩余元素,最后是整个切片。(要向右旋转,先进行第三个调用)
1
2
3
4
5
6
s := []int{0, 1, 2, 3, 4, 5}
// Rotate s left by two positions.
reverse(s[:2])
reverse(s[2:])
reverse(s)
fmt.Println(s) // "[2 3 4 5 0 1]"
注意切片的初始化表达式与数组的区别。切片字面值(slice literal)类似于数组字面值,但是未指定大小。这会隐式地创建一个合适大小的数组,并生成一个引用它的切片。与数组字面值一样,切片字面值可以按顺序指定值,或者显式指定索引,或者混合使用这两种风格。
与数组不同,切片是不可比较的,因此不能使用==来判断两个切片是否包含相同的元素。标准库提供了高度优化的bytes.Equal()函数来比较两个[]byte。但对于其他类型的切片,必须自己进行比较:
1
2
3
4
5
6
7
8
9
10
11
func equal(x, y []string) bool {
	if len(x) != len(y) {
		return false
	}
	for i := range x {
		if x[i] != y[i] {
			return false
		}
	}
	return true
}
注:Go 1.21新增的slices包提供了很多有用的泛型切片函数,其中的Equal()函数可以比较任意类型的切片,实现方式同上。
既然这种“深”相等性测试很自然,并且耗时并不比字符串和数组的==运算符更多,为什么切片不支持比较呢?有两个方面的原因。首先,切片可能包含其自身(例如元素类型为interface{}),直接比较会导致无限递归,而没有简单有效的方法处理这种情况。
其次,由于切片元素是间接引用的,当底层数组的内容被修改时,同一个切片值可能在不同时间包含不同的元素。Go的映射类型要求键的相等性在整个生命周期内保持不变,如果切片采用“深”相等性测试,就不能用作映射的键。另外,对于指针和channel等引用类型,==运算符测试引用相等性,即二者是否引用同一对象。如果切片也采用“浅”相等性测试,可以解决映射的问题,但==运算符对切片和数组的不一致处理会令人困惑。因此最安全的选择是完全禁止切片比较。(结果切片既不支持“深”相等性测试,也不能用作映射的键)
唯一合法的切片比较是与nil比较,例如
1
if summer == nil { /* ... */ }
切片类型的零值是nil。nil切片没有底层数组。nil切片的长度和容量为0,但是也有长度和容量均为0的非nil切片(例如[]int{})。也可以用类型转换表达式表示nil切片,例如[]int(nil)。
1
2
3
4
var s []int    // len(s) == 0, s == nil
s = nil        // len(s) == 0, s == nil
s = []int(nil) // len(s) == 0, s == nil
s = []int{}    // len(s) == 0, s != nil
因此,如果要判断一个切片是否为空,使用len(s) == 0,而不是s == nil。除了与nil比较等于外,nil切片的行为与零长度切片一样,例如reverse(nil)是安全的。除非文档明确说明,Go函数应该以相同的方式处理零长度切片和nil切片。
内置函数make()创建一个指定元素类型、长度和容量的切片。容量可以省略,此时容量等于长度。
1
2
make([]T, len)
make([]T, len, cap) // same as make([]T, cap)[:len]
在底层,make()创建了一个匿名数组,并返回引用它的切片。在第一种形式中,切片是整个数组的视图。在第二种形式中,切片是数组的前len个元素的视图,额外的元素留给未来增长使用。
4.2.1 append函数
内置函数append()用于向切片追加一个或多个元素,返回新的切片(注:不是原地修改,因此必须将返回值赋给原切片变量)。例如:
1
2
3
4
5
var runes []rune
for _, r := range "Hello, 世界" {
	runes = append(runes, r)
}
fmt.Printf("%q\n", runes) // "['H' 'e' 'l' 'l' 'o' ',' ' ' '世' '界']"
这个循环将字符串转换为rune切片,等价于类型转换[]rune("Hello, 世界")。
append()函数对于理解切片如何工作至关重要,因此看一下它是如何实现的。下面的appendInt()函数专门用于[]int切片:
注:Go的append()函数类似于C++的std::vector::push_back()和Java的ArrayList.add()。
每次调用appendInt()必须检查切片的底层数组是否有足够的容量来容纳新元素。如果有,则直接扩展切片z = x[:zlen](仍在原始数组中),将元素y复制到新空间,并返回切片z。输入x和结果z共享相同的底层数组。
如果没有足够的增长空间,appendInt()必须分配一个足够大的新数组(大小为原来的2倍),将x的值复制到新数组,然后添加新元素y。结果z引用的底层数组与x不同。
内置函数copy(dst, src)将元素从切片src复制到另一个相同类型的切片dst。源和目的切片可以引用相同的底层数组,甚至可以重叠。copy()返回实际复制的元素数量,等于两个切片长度中较小者,因此没有越界的风险。
为了提高效率,新数组通常略大于保存x和y所需的空间。每次扩容时将数组大小翻倍可以避免分配次数过多,并确保添加单个元素的均摊时间复杂度仍是常数。
小结:对于切片s = (arr, len, cap),append(s, v)返回的切片如下:
- 如果有足够空间(即
len < cap),则返回(arr, len+1, cap)。 - 否则需要扩容,返回
(arr_new, len+1, 2*cap)。
这个程序演示了效果:
1
2
3
4
5
6
7
8
func main() {
	var x, y []int
	for i := 0; i < 10; i++ {
		y = appendInt(x, i)
		fmt.Printf("%d  cap=%d\t%v\n", i, cap(y), y)
		x = y
	}
}
容量的每次变化都表示发生了一次扩容(分配+复制):
1
2
3
4
5
6
7
8
9
10
0  cap=1	[0]
1  cap=2	[0 1]
2  cap=4	[0 1 2]
3  cap=4	[0 1 2 3]
4  cap=8	[0 1 2 3 4]
5  cap=8	[0 1 2 3 4 5]
6  cap=8	[0 1 2 3 4 5 6]
7  cap=8	[0 1 2 3 4 5 6 7]
8  cap=16	[0 1 2 3 4 5 6 7 8]
9  cap=16	[0 1 2 3 4 5 6 7 8 9]
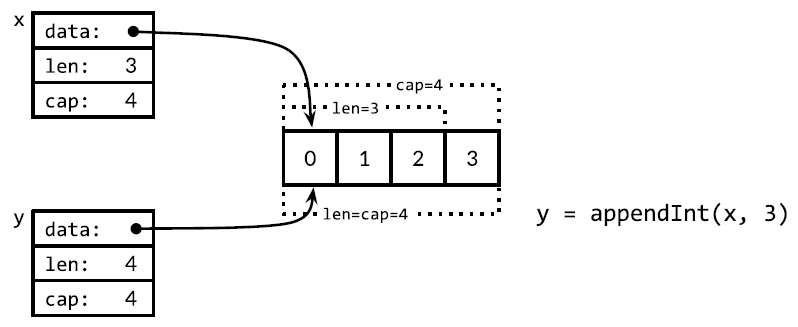
在i=3迭代中,切片x包含三个元素[0 1 2],但容量为4,末尾有一个空闲位置。因此appendInt()可以直接添加元素3,无需重新分配。得到的切片y的长度和容量都为4,与x具有相同的底层数组,如下图所示。
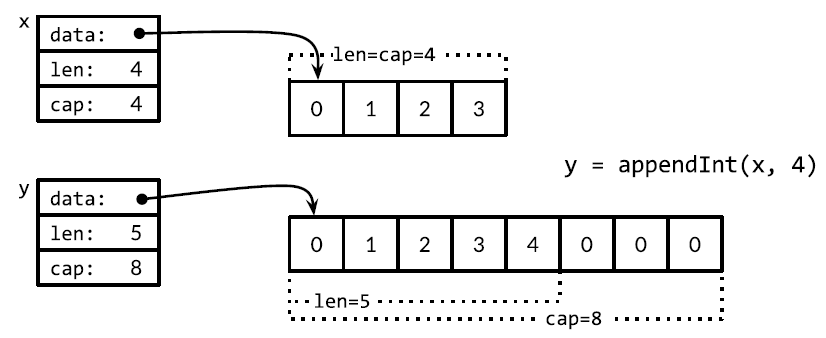
在下一次迭代中,i=4,没有空闲位置。因此appendInt()分配了一个大小为8的新数组,复制x的四个元素[0 1 2 3],并添加新元素4。得到的切片y的长度为5、容量为8,与x具有不同的底层数组,如下图所示。
内置的append()函数可能会使用比appendInt()更复杂的扩容策略。通常我们不知道一次append()调用是否会导致重新分配,因此不能假定原切片和结果切片是否引用相同的数组。因此,通常将append()返回的结果赋值给同一个切片变量:
1
runes = append(runes, r)
不仅对调用append(),对于任何可能改变切片长度、容量或底层数组的函数都需要更新切片变量。为了正确使用切片,重要的是要记住:尽管底层数组的元素是间接访问的,但切片的指针、长度和容量不是。从这个角度,切片不是“纯”引用类型,而是类似于这个结构体的聚合类型:
1
2
3
4
type IntSlice struct {
	ptr *int
	len, cap int
}
appendInt()函数只添加一个元素,而内置的append()允许添加任意多个元素。
1
2
3
4
5
6
var x []int
x = append(x, 1)
x = append(x, 2, 3)
x = append(x, 4, 5, 6)
x = append(x, x...) // append the slice x
fmt.Println(x)      // "[1 2 3 4 5 6 1 2 3 4 5 6]"
通过如下修改,可以实现内置append()的行为。声明中的省略号...表示函数是变长参数(variadic)的:接受任意数量的参数。上面调用中的省略号展示了如何将切片传递给变长参数。5.7节将详细解释这一机制。
1
2
3
4
5
6
7
func appendInt(x []int, y ...int) []int {
	var z []int
	zlen := len(x) + len(y)
	// ...expand z to at least zlen...
	copy(z[len(x):], y)
	return z
}
4.2.2 原地切片操作
下面看看更多原地修改切片元素的函数示例(像reverse()一样)。给定一个字符串切片,nonempty()函数删除所有空串并返回新的切片:
输入切片和输出切片共享相同的底层数组。这可以避免分配另一个数组,但原切片的内容会被部分覆盖,如第二条打印语句所示:
1
2
3
data := []string{"one", "", "three"}
fmt.Printf("%q\n", nonempty(data)) // `["one" "three"]`
fmt.Printf("%q\n", data)           // `["one" "three" "three"]`
因此需要这样调用该函数:data = nonempty(data)。
注:nonempty()函数所谓的“删除”操作是通过将非空字符串移到前面实现的,未被覆盖的元素仍在原数组中(例如上面的第二个"three")。这类似于C++标准库算法std::remove()。
以这种方式重用数组要求每个输入值至多产生一个输出值(即元素数量不能变多),许多过滤元素或组合相邻元素的算法都是如此。这种复杂的切片使用技巧是例外而不是规则,但有时会很清晰、高效。
切片可用于实现栈。给定一个初始为空的切片stack,可以这样实现栈操作:
- 压入:
stack = append(stack, v) // push v - 栈顶:
top := stack[len(stack)-1] // top of stack - 弹出:
stack = stack[:len(stack)-1] // pop
要从切片中间删除一个元素,并保持其余元素的顺序,可以使用copy()将后面的元素依次向前移动一位:
1
2
3
4
5
6
7
8
9
func remove(slice []int, i int) []int {
	copy(slice[i:], slice[i+1:])
	return slice[:len(slice)-1]
}

func main() {
	s := []int{5, 6, 7, 8, 9}
	fmt.Println(remove(s, 2)) // "[5 6 8 9]"
}
如果不需要保持顺序,可以直接将最后一个元素移到空位:
1
2
3
4
5
6
7
8
9
func remove(slice []int, i int) []int {
	slice[i] = slice[len(slice)-1]
	return slice[:len(slice)-1]
}

func main() {
	s := []int{5, 6, 7, 8, 9}
	fmt.Println(remove(s, 2)) // "[5 6 9 8]
}
练习4.3 重写reverse()函数,使用数组指针而不是切片。
练习4.4 重写rotate()函数,只用一次遍历完成旋转。
练习4.5 编写一个原地操作函数,删除[]string中的相邻重复元素。
练习4.6 编写一个原地操作函数,将一个UTF-8编码的[]byte中的连续空白符(见unicode.IsSpace())替换成单个空格。
练习4.7 修改reverse()函数,原地反转一个表示UTF-8编码字符串的[]byte的字符。是否可以不用分配额外内存?
4.3 映射
散列表(hash table)是无序的键/值对集合,其中所有键都是不同的。无论散列表有多大,与给定键关联的值可以通过平均常数次键比较来检索、更新或删除。
在Go中,映射(map)是对散列表的引用,映射类型写为map[K]V,其中K和V分别是键和值的类型。键类型K必须可使用==进行比较,以便测试给定的键是否已存在。虽然浮点数是可比较的,但比较浮点数是否相等是一个坏主意,尤其是可能为NaN时(如3.2节所述)。值类型V没有限制。
注:Go的map相当于C++的std::unordered_map和Java的java.util.HashMap。
可以使用内置函数make()创建一个映射:
1
ages := make(map[string]int) // mapping from strings to ints
也可以使用映射字面值创建具有初始键值对的映射:
1
2
3
4
ages := map[string]int{
	"alice": 31,
	"charlie": 34,
}
这等价于
1
2
3
ages := make(map[string]int)
ages["alice"] = 31
ages["charlie"] = 34
因此创建空映射的另一种表达式是map[string]int{}。
映射元素通过下标语法访问:
1
2
ages["alice"] = 32
fmt.Println(ages["alice"]) // "32"
使用内置函数delete()删除元素:
1
delete(ages, "alice") // remove element ages["alice"]
即使元素不在映射中,这些操作也是安全的。使用不存在的键查找映射会返回对应类型的零值。例如,即使"bob"不在映射中,下面的代码也能工作,因为ages["bob"]的值为0。
1
ages["bob"] = ages["bob"] + 1 // happy birthday!
简短赋值和自增运算符也适用于映射元素,因此上面的语句可以改写成ages["bob"] += 1或者ages["bob"]++。
(与C++不同)映射元素不是变量,不能对其取地址:
1
_ = &ages["bob"] // compile error: cannot take address of map element
禁止对映射元素取地址的一个原因是随着映射增长元素可能被重新散列,导致之前的地址失效。
要枚举映射的所有键/值对,可以使用基于范围的for循环:
1
2
3
for name, age := range ages {
	fmt.Printf("%s\t%d\n", name, age)
}
Go语言规范未指定映射的迭代顺序,不同的实现可能会使用不同的散列函数,从而导致不同的顺序。在实际中,迭代顺序是随机的,每次执行都不同。这是故意的,可以强制要求程序不依赖于具体实现。如果需要按顺序遍历键/值对,必须显式地对键进行排序。例如,如果键是字符串,可使用sort.Strings()函数:
1
2
3
4
5
6
7
8
9
10
import "sort"

names := make([]string, 0, len(ages))
for name := range ages {
	names = append(names, name)
}
sort.Strings(names)
for _, name := range names {
	fmt.Printf("%s\t%d\n", name, ages[name])
}
上面的第一个range循环只需要映射的键,所以省略了第二个循环变量。
映射类型的零值是nil,即不引用任何散列表。
1
2
3
var ages map[string]int
fmt.Println(ages == nil)    // "true"
fmt.Println(len(ages) == 0) // "true"
对映射的大部分操作(包括查找、删除、len()和遍历)都可以安全地在nil引用上执行,其行为类似于空映射。但是向nil映射存入元素会导致panic:
1
ages["carol"] = 21 // panic: assignment to entry in nil map
通过下标访问映射元素总是会产生一个值:如果键存在,则得到相应的值;否则得到零值。但有时需要判断元素是否真的存在。例如,如果值类型是数字,可能需要区分不存在的元素和值恰好为零的元素。可以像这样测试:
1
2
3
4
age, ok := ages["bob"]
if !ok {
	/* "bob" is not a key in this map; age == 0. */
}
经常会将这两个语句结合起来:
1
if age, ok := ages["bob"]; !ok { /* ... */ }
在这种情况下,映射的下标语法会产生两个值;第二个是布尔值,表示元素是否存在。这个布尔变量通常命名为ok,特别是立即用在if条件中。
与切片一样,映射不能相互比较,唯一合法的是与nil比较。要判断两个映射是否包含相同的键和值,必须写一个循环:
1
2
3
4
5
6
7
8
9
10
11
func equal(x, y map[string]int) bool {
	if len(x) != len(y) {
		return false
	}
	for k, xv := range x {
		if yv, ok := y[k]; !ok || yv != xv {
			return false
		}
	}
	return true
}
注:从Go 1.21起可以使用泛型函数maps.Equal()比较两个映射是否相等。实现代码与上面相同,但可用于任何类型的映射。
注意这里使用了!ok来区分“不存在”和“存在但为零”的情况。如果直接写y[k] != xv,下面的调用会错误地返回true:
1
2
// True if equal is written incorrectly.
equal(map[string]int{"A": 0}, map[string]int{"B": 42})
Go不提供set类型。但由于映射的键是无重复的,可以用映射来实现此目的。为了说明这一点,程序dedup读取一系列行,仅打印每个不同行的第一次出现(这是1.3节的dup程序的变体)。dedup程序使用一个映射的键记录已经出现的行。
但要注意,并非所有的map[string]bool都是“字符串集合”;有些可能包含true和false值。
有时需要键是切片的映射或集合,但由于映射的键必须是可比较的,无法直接表达这种类型(见4.2节的说明)。不过,可以分两步完成。首先,定义一个辅助函数k,将键转换为字符串,k(x) == k(y)当且仅当x和y等价(例如切片“相等”)。然后创建一个键为字符串的映射,在访问映射前对每个键调用辅助函数。
下面的示例使用一个映射记录字符串切片的出现次数。辅助函数k使用fmt.Sprintf()将字符串切片转换为适合作为映射键的单个字符串:
1
2
3
4
5
6
var m = make(map[string]int)

func k(list []string) string { return fmt.Sprintf("%q", list) }

func Add(list []string) { m[k(list)]++ }
func Count(list []string) int { return m[k(list)] }
同样的方法可用于任何不可比较的键类型。这种技术也可用于对可比较的键类型自定义相等性,例如比较字符串时不区分大小写。k的返回类型可以是任何可比较类型,例如字符串、整数、数组或结构体。
注:在C++中,std::unordered_map支持通过模板参数自定义散列函数和键相等比较函数;在Java中,HashMap直接使用键类型的hashCode()和equals()方法。
下面是映射的另一个例子,该程序统计输入中每个不同Unicode码点的出现次数。
bufio.Reader类型的ReadRune()方法读取一个或多个字节并执行UTF-8解码,返回三个值:rune、字节数和错误值。唯一预期的错误是文件结尾(io.EOF)。如果输入不是合法的UTF-8编码,则返回unicode.ReplacementChar (U+FFFD)、长度为1。
charcount程序还会打印不同UTF-8编码长度的字符数。对此映射并不是最好的数据结构,因为编码长度的范围仅为1~4 (utf8.UTFMax),数组更加紧凑。
映射的值类型可以是复合类型,例如切片或映射。在下面的代码中,映射graph的键类型是string,值类型是map[string]bool(表示字符串集合)。从概念上讲,graph将每个节点映射到有向图中的邻接点(即有向图的邻接表表示)。
addEdge()函数展示了惰性填充映射的惯用方式:在每个键首次出现时初始化对应的值。hasEdge()函数展示了如何利用不存在的映射元素的零值:即使from和to都不存在,graph[from][to]也会返回有意义的结果。
练习4.8 修改charcount程序,使用unicode.IsLetter()等函数统计字母、数字等Unicode字符类别。
练习4.9 编写一个程序wordfreq,统计输入文本文件中每个单词的出现频率。在第一次调用Scan()之前先调用input.Split(bufio.ScanWords),从而将输入拆分为单词而不是行。
4.4 结构体
结构体(struct)是一种聚合数据类型,将零个或多个任意类型的值组合成单个实体。每个值被称为字段(field)。一个经典的结构体的例子是员工记录,其字段包括员工的ID、姓名、地址、出生日期、职位、薪资、上级主管等。这些字段可以作为一个整体进行复制、传递给函数、从函数返回、存储在数组中等等。
下面的代码声明了一个名为Employee的结构体类型,以及一个名为dilbert的Employee类型的变量:
1
2
3
4
5
6
7
8
9
10
11
type Employee struct {
	ID        int
	Name      string
	Address   string
	DoB       time.Time
	Position  string
	Salary    int
	ManagerID int
}

var dilbert Employee
可以使用点运算符.访问结构体的各个字段,例如dilbert.Name。由于dilbert是一个变量,其字段也是变量,因此可以给字段赋值:
1
dilbert.Salary -= 5000 // demoted, for writing too few lines of code
或者对字段取地址,然后通过指针访问:
1
2
position := &dilbert.Position
*position = "Senior " + *position // promoted, for outsourcing to Elbonia
点运算符也适用于指向结构体的指针(省略解引用):
1
2
var employeeOfTheMonth *Employee = &dilbert
employeeOfTheMonth.Position += " (proactive team player)"
其中employeeOfTheMonth.Position等价于(*employeeOfTheMonth).Position。
函数EmployeeByID()返回指向具有给定ID的Employee的指针。可以使用.访问返回值的字段:
1
2
3
4
5
6
func EmployeeByID(id int) *Employee { /* ... */ }

fmt.Println(EmployeeByID(dilbert.ManagerID).Position) // "Pointy-haired boss"

id := dilbert.ID
EmployeeByID(id).Salary = 0 // fired for... no real reason
最后一条语句更新了EmployeeByID()的调用结果所指向的Employee结构体。如果EmployeeByID()的返回类型从*Employee改为Employee,那么这条赋值语句将编译失败,因为赋值号左侧并不标识(identify)一个变量(即不可赋值)。
声明结构体时,通常每个字段占一行,字段名在前,类型在后。但类型相同的连续字段可以合并声明,例如下面的Name和Address:
1
2
3
4
5
type Employee struct {
	ID            int
	Name, Address string
	...
}
字段顺序对于类型标识至关重要。如果也合并了Position字段的声明,或者交换了Name和Address的顺序,就会定义出不同的结构体类型。通常,只合并相关字段的声明。
和所有命名一样,如果结构体字段名以大写字母开头,该字段就是导出的(见2.1节)。一个结构体类型可以同时包含导出和非导出字段。
结构体类型往往很冗长,因为通常每个字段都占用一行。尽管可以每次使用时都写出完整类型,但这种重复会很繁琐。因此,结构体类型通常出现在像Employee这样的命名类型声明中。
注:如2.5节所述,type Employee struct {...}是命名类型声明语句。结构体类型struct {...}也可以在其他声明中单独使用。例如,下面定义了一个结构体切片points:
1
2
3
4
5
6
points := []struct {
	X, Y int
}{
	{1, 2},
	{3, 4},
}
名为S的结构体类型不能声明类型同样为S的字段:聚合值不能包含其自身(数组也有类似的限制)。但S可以声明指针类型*S的字段,这使得可以创建递归数据结构(例如链表和树)。下面的代码展示了这一点,使用二叉树实现了插入排序:
结构体的零值由其每个字段的零值构成。通常零值是一个合理的默认值。例如,bytes.Buffer的零值是一个直接可用的空缓冲区,sync.Mutex(将在第9章讨论)的零值是一个未锁定的互斥锁。有时这种合理的默认行为是自然具备的,但有时则需要类型设计者专门进行设计。
不包含任何字段的结构体类型称为空结构体,写作struct{}。其大小为0、不携带任何信息,但在某些场景下依然有用。有些Go程序员使用空结构体而不是bool作为用于表示集合的映射的值类型,以强调只有键是有意义的。不过,这种做法节省的空间微乎其微,且语法较为繁琐,因此通常不推荐这样做。
1
2
3
4
5
6
seen := make(map[string]struct{}) // set of strings
// ...
if _, ok := seen[s]; !ok {
	seen[s] = struct{}{}
	// ...first time seeing s...
}
4.4.1 结构体字面值
结构体类型的值可以通过结构体字面值来创建,指定各个字段的值。
1
2
3
type Point struct{ X, Y int }

p := Point{1, 2}
结构体字面值有两种形式。第一种形式(如上所示)需要按顺序为每个字段指定一个值。这要求写代码和读代码的人必须准确记住字段的定义,而且一旦后续增加字段或调整字段顺序,代码就会变得难以维护。因此,这种形式通常只在定义结构体类型的包内部使用,或者用于有显而易见的字段顺序约定的小型结构体,例如image.Point{x, y}或color.RGBA{red, green, blue, alpha}。
第二种形式更常用,列出部分或全部字段名及其对应的值。例如1.4节Lissajous程序中的以下语句:
1
anim := gif.GIF{LoopCount: nframes}
在这种形式中,省略的字段将被赋予其类型的零值。由于指定了字段名,字段的顺序就不重要了。
这两种形式不能在同一个字面值中混用。另外,也不能利用第一种形式来绕过“非导出的标识符不能在其他包中访问”这一规则。
1
2
3
4
5
6
7
package p
type T struct{ a, b int } // a and b are not exported

package q
import "p"
var x = p.T{a: 1, b: 2} // compile error: can't reference a, b
var y = p.T{1, 2}       // compile error: can't reference a, b
尽管最后一行代码没有显式提到非导出的字段名,但实际上隐式使用了这些字段,因此是不允许的。
结构体值可以作为参数传递给函数,也可以从函数返回。例如,下面的函数将Point缩放指定的倍数:
1
2
3
4
5
func Scale(p Point, factor int) Point {
	return Point{p.X * factor, p.Y * factor}
}

fmt.Println(Scale(Point{1, 2}, 5)) // "{5 10}"
结构体是按值传递的。为了效率起见,大结构体通常通过指针间接传递给函数或从函数返回。
1
2
3
func Bonus(e *Employee, percent int) int {
	return e.Salary * percent / 100
}
如果函数需要修改参数,则必须这样做。因为在像Go这样按值调用的语言中,函数只接收到参数的副本,而不是原始参数的引用。
1
2
3
func AwardAnnualRaise(e *Employee) {
	e.Salary = e.Salary * 105 / 100
}
由于通过指针处理结构体非常常见,可以使用以下简写形式来创建一个结构体变量并获取其地址:
1
pp := &Point{1, 2}
这等价于
1
2
pp := new(Point)
*pp = Point{1, 2}
不过&Point{1, 2}可以直接在表达式中使用,例如函数调用。
4.4.2 比较结构体
如果结构体的所有字段都是可比较的,那么该结构体本身也是可比较的。==运算符会按顺序比较两个结构体的对应字段,因此下面的两个比较表达式是等价的:
1
2
3
4
5
6
type Point struct{ X, Y int }

p := Point{1, 2}
q := Point{2, 1}
fmt.Println(p.X == q.X && p.Y == q.Y) // "false"
fmt.Println(p == q)                   // "false"
可比较的结构体类型可以用作映射的键类型。
1
2
3
4
5
6
7
type address struct {
	hostname string
	port int
}

hits := make(map[address]int)
hits[address{"golang.org", 443}]++
4.4.3 结构体嵌入和匿名字段
本节将介绍Go语言独特的结构体嵌入(struct embedding)机制。该机制允许将一个命名结构体类型作为另一个结构体类型的匿名字段,从而提供了一种语法捷径:表达式x.f可以代表像x.d.e.f这样的一连串字段访问。
考虑一个2D绘图程序,提供了一个形状库(例如矩形、椭圆、星形和轮子等)。以下是该程序可能定义的两种类型:
1
2
3
4
5
6
7
type Circle struct {
	X, Y, Radius int
}

type Wheel struct {
	X, Y, Radius, Spokes int
}
圆形Circle的字段包括圆心坐标X和Y以及半径Radius。轮子Wheel不仅具有Circle的所有字段,还增加了Spokes,用于表示轮辐的数量。创建一个Wheel实例:
1
2
3
4
5
var w Wheel
w.X = 8
w.Y = 8
w.Radius = 5
w.Spokes = 20
随着形状种类的增加,我们必然会注意到它们之间存在相似之处和重复性,因此将它们的公共部分提取出来会更方便:
1
2
3
4
5
6
7
8
9
10
11
12
13
type Point struct {
	X, Y int
}

type Circle struct {
	Center Point
	Radius int
}

type Wheel struct {
	Circle Circle
	Spokes int
}
虽然这样做可能更清晰,但同时也导致访问Wheel的字段变得更加繁琐:
1
2
3
4
5
var w Wheel
w.Circle.Center.X = 8
w.Circle.Center.Y = 8
w.Circle.Radius = 5
w.Spokes = 20
Go允许声明一个只有类型而没有名字的字段,这种字段称为匿名字段(anonymous field)。匿名字段的类型必须是命名类型或指向命名类型的指针。如下所示,Circle和Wheel各有一个匿名字段。我们说Point 嵌入到 Circle 中,Circle嵌入到Wheel中。
1
2
3
4
5
6
7
8
9
type Circle struct {
	Point
	Radius int
}

type Wheel struct {
	Circle
	Spokes int
}
得益于嵌入机制,我们可以直接访问这棵“树”的叶字段,而无需写出中间名字:
1
2
3
4
5
var w Wheel
w.X = 8        // equivalent to w.Circle.Point.X = 8
w.Y = 8        // equivalent to w.Circle.Point.Y = 8
w.Radius = 5   // equivalent to w.Circle.Radius = 5
w.Spokes = 20
上述注释中展示的显式写法依然有效,这也说明“匿名字段”这一称呼并不完全准确。字段Circle和Point其实有名字——即各自类型的名字,但这些名字在点号表达式中是可选的。在访问其子字段时,可以省略任意或全部的匿名字段名字。
遗憾的是,结构体字面值语法并没有相应的简写形式。因此以下两种写法都无法通过编译:
1
2
w = Wheel{8, 8, 5, 20}                       // compile error: unknown fields
w = Wheel{X: 8, Y: 8, Radius: 5, Spokes: 20} // compile error: unknown fields
结构体字面值必须遵循类型声明的结构,因此必须采用以下两种形式之一(二者是等价的):
1
2
3
4
5
6
7
8
9
w = Wheel{Circle{Point{8, 8}, 5}, 20}

w = Wheel{
	Circle: Circle{
		Point:  Point{X: 8, Y: 8},
		Radius: 5,
	},
	Spokes: 20, // NOTE: trailing comma necessary here (and at Radius)
}
注意,副词#会使Printf()的动词%v以类似Go语法的形式打印值。对于结构体值,这种形式会包含字段名,例如Wheel{Circle:Circle{Point:Point{X:8, Y:8}, Radius:5}, Spokes:20}。如果不加#,则打印结果为{{{8 8} 5} 20}。
由于匿名字段实际上有隐式名字,因此不能有两个相同类型的匿名字段,否则它们的名字会冲突。另外,匿名字段的名字是由其类型隐式决定的,字段的可见性也是。在上述示例中,匿名字段Point和Circle都是导出的。假设它们不是导出的(point和circle),仍然可以使用简写形式
1
w.X = 8 // equivalent to w.circle.point.X = 8
但外部包中禁止使用注释中所示的显式形式,因为circle和point不可访问。
注:如果两个匿名字段包含同名的子字段,则访问该字段时必须写出中间名字,否则会有歧义导致编译失败。例如:
1
2
3
4
5
6
7
8
9
10
11
12
type A struct{ X int }

type B struct{ X int }

type C struct {
	A
	B
}

c := C{A{1}, B{2}}
fmt.Println(c.X)   // compile error: ambiguous selector c.X
fmt.Println(c.A.X) // OK, prints "1"
目前所看到的结构体嵌入仅仅是针对访问结构体字段的一种语法糖。稍后将会看到,匿名字段不一定是结构体类型,任何命名类型或命名类型的指针都可以。但是为什么要嵌入一个没有子字段的类型呢?
答案与方法有关。用于访问嵌入类型字段的简写语法同样适用于访问其方法。实际上,外层结构体类型不仅获得了嵌入类型的字段,还获得了其方法。这种机制正是将简单对象组合成复杂对象的主要方式。组合(composition)是Go语言中面向对象编程的核心,将在6.3节进一步探讨。
4.5 JSON
JavaScript对象表示法(JavaScript Object Notation, JSON)是一种用于发送和接收结构化信息的标准表示法。JSON并非唯一选择,XML(7.14节)、ASN.1和Google的Protocol Buffers都是用于此类目的,且各有其适用场景。但JSON由于简洁性、易读性、普遍支持,成为应用最广泛的一种。
Go为这些格式的编码与解码提供了出色的支持,由标准库的encoding/json、encoding/xml、encoding/asn1等包提供,并且这些包都有相似的API(注:Protocol Buffers支持由google.golang.org/protobuf模块提供)。本节将简要介绍encoding/json包最核心的内容。
JSON是一种将JavaScript值编码为文本的格式。JSON的基本类型包括数字(十进制或科学计数法)、布尔值(true或false)和字符串(双引号括起来的Unicode码点序列)。
这些基本类型可以通过JSON数组和对象进行递归组合。
- JSON数组(array)是值的有序序列,用逗号分隔、方括号括起来的列表表示。JSON数组用于编码Go数组和切片。
- JSON对象(object)是从字符串到值的映射,用逗号分隔、花括号括起来的
name:value序列表示。JSON对象用于编码Go映射(键为字符串)和结构体。
例如:
| JSON类型 | 示例 |
|---|---|
| 布尔值 | true |
| 数字 | -273.15 |
| 字符串 | "She said \"Hello, 世界\"" |
| 数组 | ["gold", "silver", "bronze"] |
| 对象 | {"year": 1980,"event": "archery","medals": ["gold", "silver", "bronze"]} |
考虑一个收集影评并提供推荐的应用程序。数据类型Movie及一组值如下所示。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
type Movie struct {
	Title  string
	Year   int  `json:"released"`
	Color  bool `json:"color,omitempty"`
	Actors []string
}

var movies = []Movie{
	{Title: "Casablanca", Year: 1942, Color: false,
		Actors: []string{"Humphrey Bogart", "Ingrid Bergman"}},
	{Title: "Cool Hand Luke", Year: 1967, Color: true,
		Actors: []string{"Paul Newman"}},
	{Title: "Bullitt", Year: 1968, Color: true,
		Actors: []string{"Steve McQueen", "Jacqueline Bisset"}},
	// ...
}
这样的数据结构非常适合使用JSON表示,并且相互转换也很容易。将Go数据结构转换为JSON的过程称为编码(marshaling)。编码操作由json.Marshal()函数完成:
1
2
3
4
5
data, err := json.Marshal(movies)
if err != nil {
	log.Fatalf("JSON marshaling failed: %s", err)
}
fmt.Printf("%s\n", data)
Marshal()会生成一个字节切片,包含很长的字符串,且不含多余的空白字符:
1
[{"Title":"Casablanca","released":1942,"Actors":["Humphrey Bogart","Ingrid Bergman"]},{"Title":"Cool Hand Luke","released":1967,"color":true,"Actors":["Paul Newman"]},{"Title":"Bullitt","released":1968,"color":true,"Actors":["Steve McQueen","Jacqueline Bisset"]}]
这种紧凑的格式虽然包含了所有信息,但很难阅读。为了便于人类阅读,可以使用json.MarshalIndent(),它能产生整齐缩进的输出。该函数接受两个额外参数,分别指定每行输出的前缀以及每一级缩进所使用的字符串:
1
2
3
4
5
data, err := json.MarshalIndent(movies, "", "    ")
if err != nil {
	log.Fatalf("JSON marshaling failed: %s", err)
}
fmt.Printf("%s\n", data)
上面的代码将打印
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
[
    {
        "Title": "Casablanca",
        "released": 1942,
        "Actors": [
            "Humphrey Bogart",
            "Ingrid Bergman"
        ]
    },
    {
        "Title": "Cool Hand Luke",
        "released": 1967,
        "color": true,
        "Actors": [
            "Paul Newman"
        ]
    },
    {
        "Title": "Bullitt",
        "released": 1968,
        "color": true,
        "Actors": [
            "Steve McQueen",
            "Jacqueline Bisset"
        ]
    }
]
编码时,默认使用Go结构体字段名作为JSON对象的键(通过反射,详见12.6节)。只有导出字段才会被编码。
在上面的输出结果中Year字段变成了released,而Color变成了color。这是因为使用了字段标签(field tag)。字段标签是一种在编译时与结构体字段关联的元数据字符串:
1
2
Year   int  `json:"released"`
Color  bool `json:"color,omitempty"`
字段标签可以是任意字符串字面值,但通常是空格分隔的key:"value"对列表。由于包含双引号,字段标签通常用原始字符串字面值(反引号括起来)书写。json键控制encoding/json包的行为,其他encoding/...包也遵循这一惯例。
json字段标签的第一部分指定了Go字段对应的JSON名字,常用于指定符合JSON命名习惯的名字(例如Go字段TotalCount对应到JSON名字total_count)。Color字段的标签包含一个额外的选项omitempty,表示如果该字段的值为其类型的零值或为空,则不在JSON输出中包含该字段。因此黑白电影 “Casablanca” 的JSON输出中不包含color字段。
编码的逆操作称为解码(unmarshaling),将JSON解析为Go数据结构。该操作由json.Unmarshal()函数完成。下面的代码将JSON格式的电影数据解码为一个结构体切片,该结构体仅包含Title字段。通过定义合适的Go数据结构,我们可以选择性地解码JSON输入中的部分内容,其他JSON字段将被忽略。
1
2
3
4
5
var titles []struct{ Title string }
if err := json.Unmarshal(data, &titles); err != nil {
	log.Fatalf("JSON unmarshaling failed: %s", err)
}
fmt.Println(titles) // "[{Casablanca} {Cool Hand Luke} {Bullitt}]"
许多Web服务都提供JSON接口(称为REST API)——通过HTTP发起请求,并以JSON格式返回信息。为了说明这一点,下面使用GitHub的Web服务接口来查询issue。首先定义必要的类型和常量:
注:GitHub issue查询接口的请求和响应结构详见文档Search issues and pull requests。
与之前一样,所有结构体字段名也必须首字母大写,即使对应的JSON名字未大写。不过,在解码过程中将JSON名字与Go结构体字段名匹配时是不区分大小写的。因此只有当JSON 名字包含下划线时才需要使用字段标签。另外,这里也是只选择了部分字段进行解码,GitHub响应包含的信息比这里展示的要多得多。
SearchIssues()函数发起HTTP请求并将结果解码为JSON。由于用户提供的查询词可能包含?和&等特殊字符,因此使用url.QueryEscape()进行处理。
上一个示例使用json.Unmarshal()将字节切片的全部内容解码为单个JSON实体。这个例子使用了流式解码器json.Decoder,它允许从同一个流中依次解码多个JSON实体(例如JSON Lines格式),尽管在这里并不需要这一特性。对应的流式编码器叫做json.Encoder。
调用Decode()会填充变量result。我们可以通过多种方式美观地格式化其值。最简单的方式是固定列宽的文本表格(如下面的issues程序所示)。在下一节中,将看到一种更复杂的基于模板的方式。
通过命令行参数指定搜索词。下面的命令查询Go语言项目issue中与JSON解码相关的、处于打开状态的bug:
1
2
3
4
5
6
7
8
9
10
11
12
$ go build gopl.io/ch4/issues
$ ./issues repo:golang/go is:open json decoder
87 issues:
#80117     dsnet encoding/json/jsontext: Decoder.Reset and Encoder.Reset
#81033   itchyny encoding/json: Decoder.More reports a SyntaxError inste
#81050 adamroyjo encoding/json: fmt.Print representation of json.RawMess
#43513 Alexander proposal: encoding/json/v2, encoding/json/jsontext: add
#71475  oiweiwei encoding/json: improve decoder alloc count
#80885  thepudds encoding/json/v2: possibly clarify retention prohibitio
#80115     dsnet encoding/json/jsontext: make trailing comma error more
#81062 IBlackVoi encoding/json: Unmarshal leaves ±Inf in the destination
...
GitHub Web服务接口的功能远比这里介绍的多,详见GitHub REST API文档。
练习4.10 修改issue程序,根据结果的时间进行分类,例如不到一个月、不到一年、超过一年。
练习4.11 编写一个工具,允许用户通过命令行创建、读取、更新和关闭GitHub issue。当需要输入大量文本时,调用用户偏好的文本编辑器。
练习4.12 流行网络漫画xkcd (https://xkcd.com/)提供了JSON接口。例如,请求 https://xkcd.com/571/info.0.json 会返回漫画571的详细描述。下载每个URL(仅一次)并构建离线索引。编写一个工具xkcd,利用该索引打印与命令行提供的搜索词相匹配的每则漫画的URL和文本内容。
练习4.13 Open Movie Database (https://omdbapi.com/)提供的基于JSON的 Web服务允许用户通过名字搜索电影并下载海报图像。编写一个工具poster,下载命令行指定名字的电影的海报图像。
4.6 文本和HTML模板
前面的例子仅做了最简单的格式化,Printf()完全足够了。但有时需要更复杂的格式化,此时最好将格式与代码完全分离。这可以通过text/template和html/template包来实现,它们提供了一种将变量值替换到文本或HTML模板中的机制。
4.6.1 文本模板
模板(template)是一个字符串或文件,其中包含一个或多个由双大括号括起来的占位符{{...}},称为动作(action)。大部分字符串会原样输出,而动作会触发其他行为。每个动作都包含一个模板语言的表达式,用于打印值、访问结构体字段、调用函数和方法、表达控制流(如if-else语句和range循环)以及实例化其他模板。一个简单的模板字符串如下所示:
1
2
3
4
5
6
7
const templ = `{{.TotalCount}} issues:
{{range .Items}}----------------------------------------
Number: {{.Number}}
User:   {{.User.Login}}
Title:  {{.Title | printf "%.64s"}}
Age:    {{.CreatedAt | daysAgo}} days
{{end}}`
这个模板首先打印匹配的issue数量,然后依次打印每个issue的编号、用户、标题和创建至今的天数。在动作内部有一个“当前值”的概念,称为“点”(dot),写作.。一开始,当前值是模板的参数,在这个例中是IssuesSearchResult类型。动作{{.TotalCount}}会展开为其TotalCount字段的值。动作{{range .Items}}和{{end}}创建了一个循环,因此它们之间的文本会被多次展开,当前值依次引用Items的各个元素。
在动作内部,|符号将一个操作的结果作为另一个操作的参数(类似于Unix shell管道)。对于Title字段,第二个操作是printf函数,这是fmt.Sprintf()的内置别名。对于Age,第二个操作是下面的daysAgo()函数,使用time.Since()将CreatedAt字段转换为已过去的时间:
1
2
3
func daysAgo(t time.Time) int {
	return int(time.Since(t).Hours() / 24)
}
注意,CreatedAt的类型是time.Time,而不是string。如2.5节所述,类型可以通过定义String()方法来控制其字符串格式化。同样地,类型也可以定义方法来控制其JSON编码和解码行为(注:需要分别实现json.Marshaler和json.Unmarshaler接口)。time.Time类型的JSON编码值是一个标准格式的字符串。
使用模板生成输出包括两个步骤。首先要将模板解析为合适的内部表示,然后针对特定的输入执行该模板。解析只需做一次。下面的代码创建并解析了前面定义的模板templ。注意方法调用链:
template.New()创建并返回一个模板;Funcs()注册自定义函数daysAgo;- 最后对结果调用
Parse()。
1
2
3
4
5
6
report, err := template.New("report").
	Funcs(template.FuncMap{"daysAgo": daysAgo}).
	Parse(templ)
if err != nil {
	log.Fatal(err)
}
由于模板通常在编译时已确定,模板解析失败通常意味着程序存在致命错误。辅助函数template.Must()简化了错误处理:接收一个模板和错误值,检查错误是否为nil(如果不是则panic),然后返回该模板。我们将在5.9节再次讨论这一思想。
一旦模板创建完成,就可以执行它了,使用IssuesSearchResult作为数据源、os.Stdout作为输出目标:
1
2
3
4
5
6
7
8
9
10
11
12
13
var report = template.Must(template.New("issuelist").
	Funcs(template.FuncMap{"daysAgo": daysAgo}).
	Parse(templ))

func main() {
	result, err := github.SearchIssues(os.Args[1:])
	if err != nil {
		log.Fatal(err)
	}
	if err := report.Execute(os.Stdout, result); err != nil {
		log.Fatal(err)
	}
}
程序会输出一个纯文本报告,如下所示:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
$ go build gopl.io/ch4/issuesreport
$ ./issuesreport repo:golang/go is:open json decoder
87 issues:
----------------------------------------
Number: 80117
User:   dsnet
Title:  encoding/json/jsontext: Decoder.Reset and Encoder.Reset should a
Age:    103 days
----------------------------------------
Number: 81033
User:   itchyny
Title:  encoding/json: Decoder.More reports a SyntaxError instead of io.
Age:    43 days
----------------------------------------
...
4.6.2 HTML模板
现在转到html/template包。它使用与text/template相同的API和模板语言,但增加了自动转义特性,能够针对出现在HTML、JavaScript、CSS或URL中的字符串进行处理。这有助于避免HTML生成中一个长期存在的安全问题——注入攻击。攻击者会精心构造一个包含恶意代码的字符串(例如issue标题),如果模板未能正确转义该字符串,就会让攻击者控制页面。
下面的模板将issue列表渲染为HTML表格:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import "html/template"

var issueList = template.Must(template.New("issuelist").Parse(`
<h1>{{.TotalCount}} issues</h1>
<table>
<tr style='text-align: left'>
  <th>#</th>
  <th>State</th>
  <th>User</th>
  <th>Title</th>
</tr>
{{range .Items}}
<tr>
  <td><a href='{{.HTMLURL}}'>{{.Number}}</a></td>
  <td>{{.State}}</td>
  <td><a href='{{.User.HTMLURL}}'>{{.User.Login}}</a></td>
  <td><a href='{{.HTMLURL}}'>{{.Title}}</a></td>
</tr>
{{end}}
</table>
`))
下面的命令用一个稍微不同的查询执行该模板:
1
2
$ go build gopl.io/ch4/issueshtml
$ ./issueshtml repo:golang/go commenter:gopherbot json encoder > issues.html
下图显示了表格在浏览器中的效果。
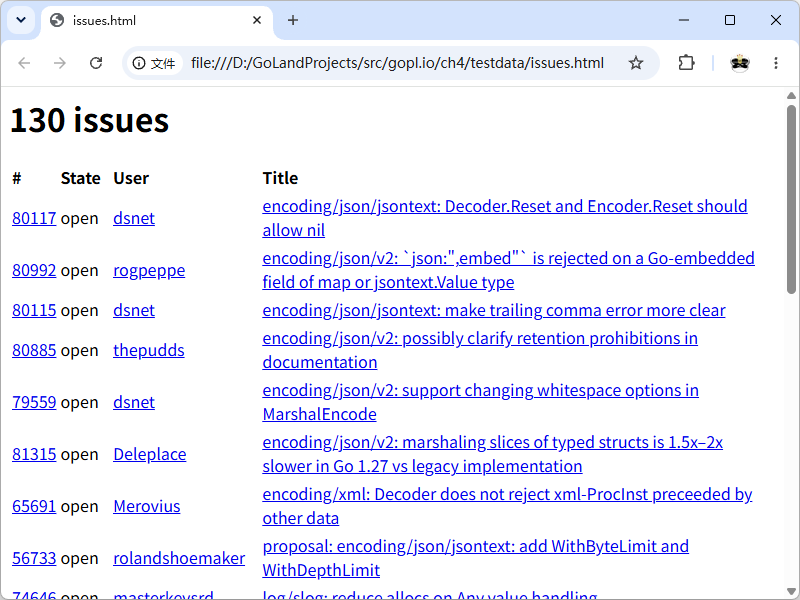
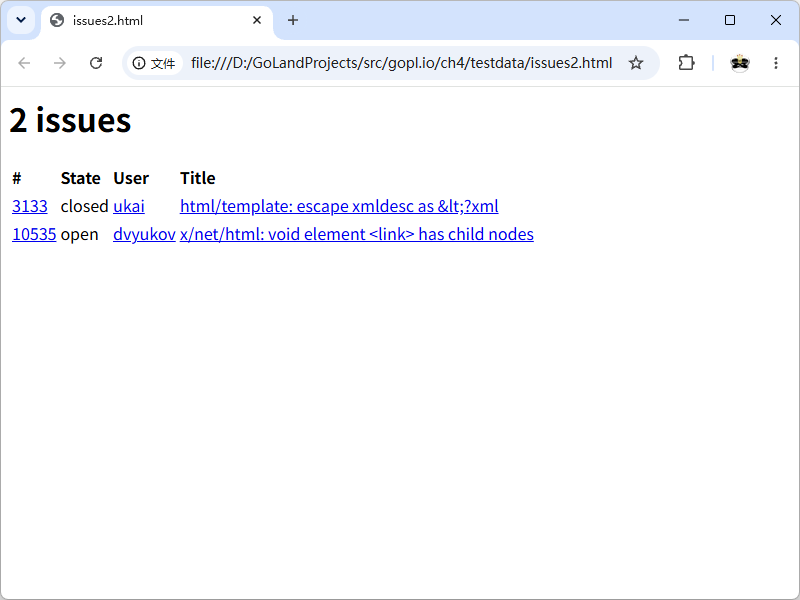
上图中的issue都不包含特殊字符。为了看到issue标题包含HTML元字符(如&和<)的影响,我们选择了以下两个issue:
1
$ ./issueshtml repo:golang/go 3133 10535 > issues2.html
下显示了该查询的结果。注意,html/template包会自动转义标题(例如将"<?xml"替换为"&lt;?xml"、"<link>"替换为"<link>"),使其按原样显示。如果使用text/template包,字符串"<"将被显示为字符'<',字符串"<link>"将成为link元素,从而改变HTML文档的结构,并可能损害其安全性。
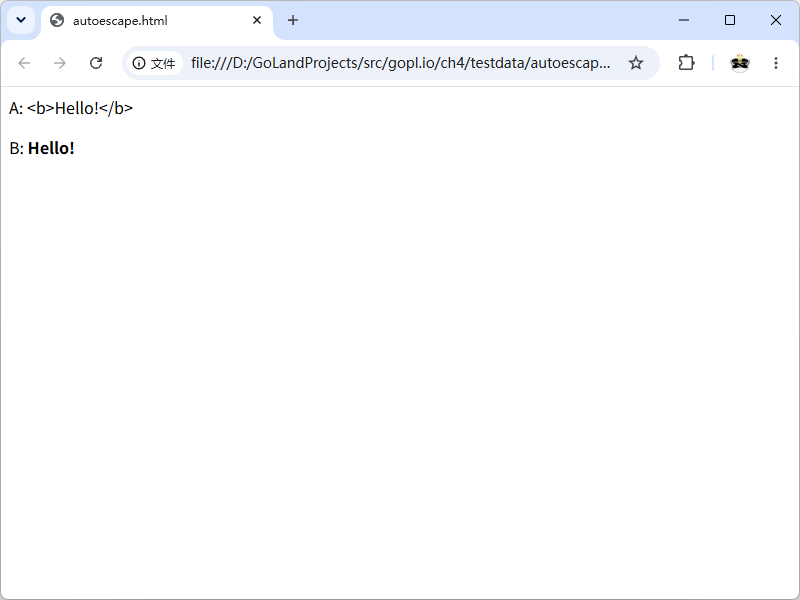
对于包含可信HTML数据的字段,可以通过使用命名字符串类型template.HTML而不是string来抑制这种自动转义行为。对于可信的JavaScript、CSS和URL存在类似的命名类型。下面的程序使用两个值相同但类型不同的字段来演示这一原理:A是string,B是template.HTML。
下图显示了模板输出在浏览器中的效果。可以看到A被转义了(<b>加粗失效),但B没有。
这里只讲述了模板系统的最基本特性。更多信息参见包文档text/template和html/template:
1
2
$ go doc text/template
$ go doc html/template
练习4.14 创建一个Web服务器,查询一次GitHub,然后生成错误报告、里程碑和用户的导航列表。